

Анатолій Даньков
CTO
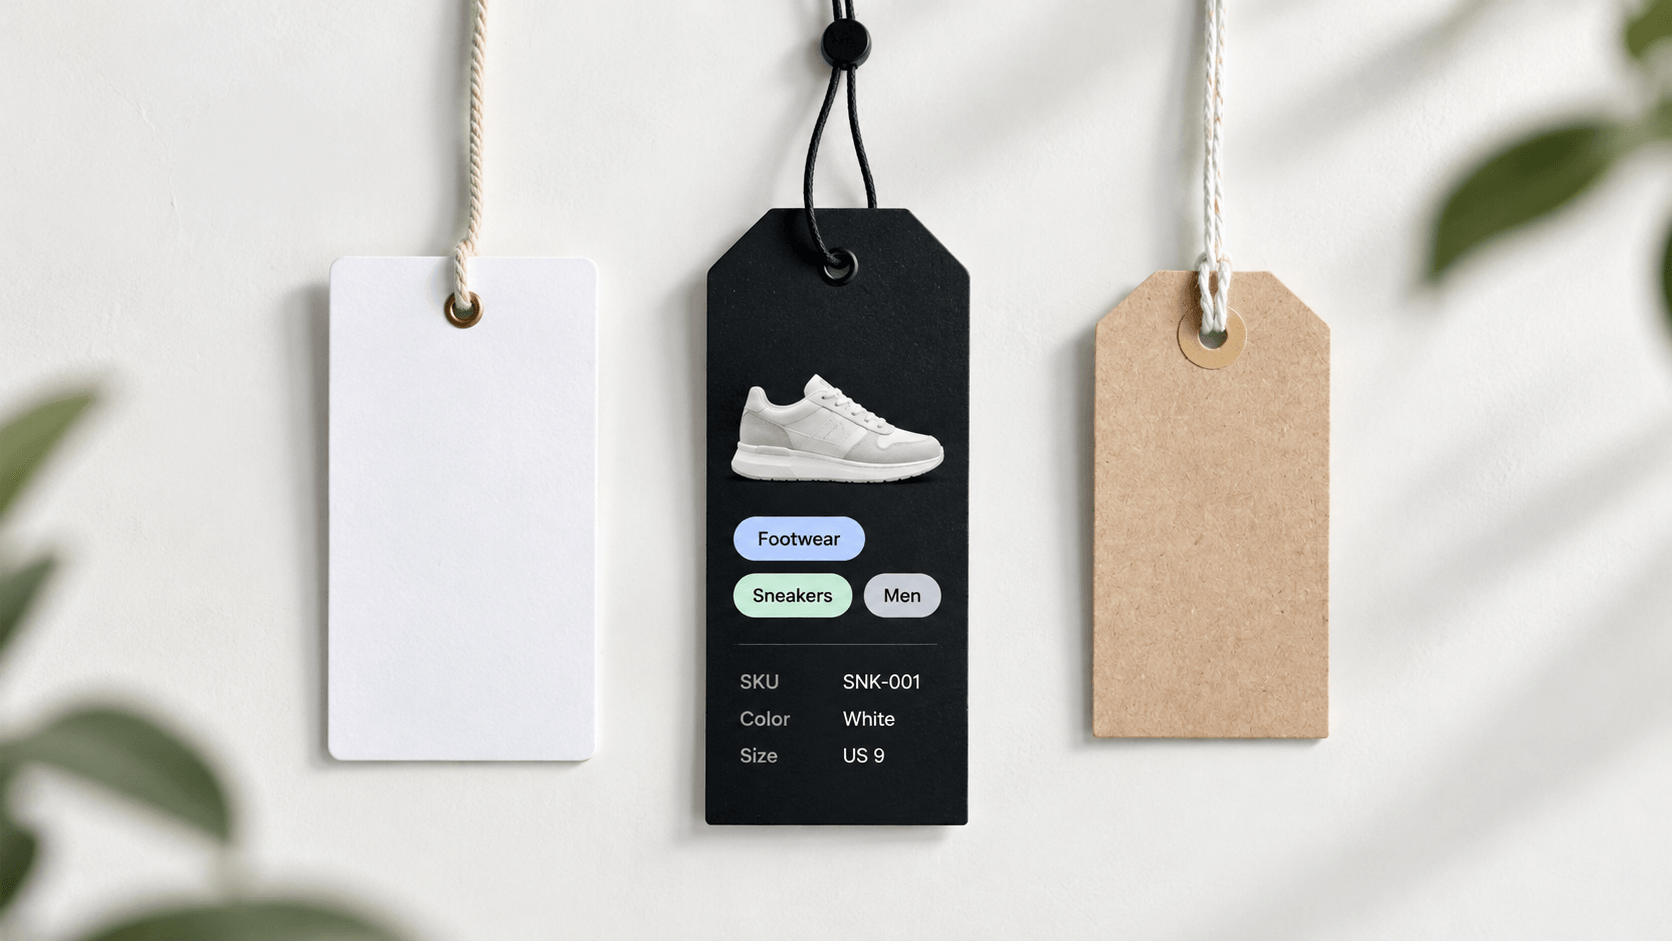
Каталог інтернет-магазину рідко втрачає продажі через назву товару. Значно частіше причина в характеристиках: матеріал, розмір, колір чи сумісність кожен постачальник описує по-своєму або не вказує зовсім, і товар зникає з результатів, щойно покупець вмикає фільтр. На маркетплейсі така картка товару може взагалі не пройти модерацію, бо обов'язкові поля категорії залишилися порожніми.
Автоматична класифікація товарів закриває цю прогалину. Система читає назву, опис, фото й файли постачальника, відносить товар до категорії вашого каталогу і заповнює атрибути й теги значеннями з погодженого списку. Саме так працює HootCore AI Enrichment, де кожне значення має оцінку впевненості й посилання на джерело, з якого його взято.
У статті розглянемо етапи автоматичної класифікації та покажемо, як виглядає картка товару до і після неї. Також розберемо, що вимагають маркетплейси і які перевірки варто налаштувати перед публікацією.
Класифікація товарів в e-commerce означає віднесення кожного товару до категорії в дереві каталогу та заповнення характеристик, які для цієї категорії визначені. Поруч із нею працює тегування, і разом вони створюють три різні типи даних:
Тип даних | Що робить | Приклад |
|---|---|---|
Категорія | Визначає місце товару в каталозі й набір його характеристик | Меблі > Їдальня > Стільці |
Атрибут | Зберігає назву властивості та її значення | Матеріал оббивки: тканина |
Тег | Групує товари з різних категорій | комплект 2 шт |
Значення атрибута може водночас бути тегом. Магазин може використовувати бавовну і як значення матеріалу, і як мітку для добірки базового одягу.
Коли характеристики заповнює співробітник, він відкриває кожен файл постачальника, шукає специфікації на сайті виробника і переносить значення в картку. Для кількох сотень позицій цього достатньо, але з кожним новим постачальником обсяг роботи зростає разом з асортиментом. Автоматичне тегування товарів змінює роль команди, бо система пропонує значення, а фахівці перевіряють лише ті, у яких вона не впевнена.
Автоматична класифікація спирається на правила, AI-моделі або їх поєднання. Правила присвоюють теги на основі підтверджених атрибутів, а модель розпізнає різні формулювання постачальників і зводить їх до єдиного словника каталогу. Жоден із методів не повинен перетворювати неповну інформацію на непідтверджене твердження: опис, де згадано лише метал, не дає підстав записати нержавіючу сталь.
Автоматична класифікація проходить кілька послідовних етапів. Розуміння кожного з них допомагає команді побачити, де в процес потрапляють помилки і що варто перевіряти перед публікацією.
[Схема: дані постачальника → визначення атрибутів → віднесення до категорії → нормалізація значень → присвоєння тегів → оцінка впевненості → перевірка й публікація]
 Збір вхідних даних
Процес починається з інформації, яка вже є: назва й опис від постачальника, специфікації, наявні атрибути та категорії. Частина систем також аналізує фото товару та сторінки виробника.
Кожне джерело має описувати саме цей товар і цей варіант. Детальна специфікація схожої моделі принесе в картку більше помилок, ніж короткий, але точний рядок із прайсу постачальника.
Визначення атрибутівСистема знаходить значення для полів на зразок матеріалу, розмірів, кольору чи потужності. Текстова модель витягує специфікації з описів і документів, а аналіз зображень додає видимі ознаки, як-от візерунок чи форму горловини.
Коли інформації бракує, AI-збагачення може отримати додаткові атрибути з перевірених джерел. Склад матеріалу чи сумісність пристроїв ніколи не варто визначати лише за зовнішнім виглядом.
Віднесення до категоріїСистема відносить товар до категорії каталогу, і саме категорія визначає, які характеристики для нього обов'язкові. Для босоніжок це висота підбора й тип ремінця, для монітора це діагональ і роздільна здатність.
Класифікація та визначення атрибутів перевіряють одне одного. Наявна категорія підказує, які поля шукати, а знайдені атрибути показують, чи правильно товар віднесено.
Нормалізація значеньЗнайдені значення зводяться до погодженого словника й форматів каталогу. Наприклад, inox і нержавіюча сталь перетворюються на одне допустиме значення матеріалу, а сантиметри й дюйми приводяться до однієї одиниці.
З кольорами варто бути обережнішими. Магазин може об'єднати темно-синій і чорнильний у фільтрі синій, але зберегти оригінальний відтінок в окремому полі, щоб навігація стала простішою без втрати відмінностей між товарами.
Присвоєння тегівНа основі підтверджених атрибутів і правил каталогу система присвоює теги, і підтверджене значення бавовна в полі матеріалу дає тег бавовна.
Окремий тег потрібен не кожному полю. Числові характеристики краще працюють як атрибути для фільтрів, описові мітки корисніші для добірок, і кожен тег має виконувати конкретне завдання в магазині.
Оцінка впевненості та джерело значенняОцінка впевненості показує, які значення першочергово потребують перевірки, а посилання на джерело дає фахівцеві змогу побачити, звідки значення взялося.
Жоден із цих сигналів сам по собі не гарантує точності. Значення з високою оцінкою все одно може належати іншому варіанту товару, а суперечливі джерела варто розібрати, а не обирати те, що трапляється частіше.
Перевірка і публікаціяКоманда визначає, які значення йдуть на перевірку і хто їх підтверджує, а правила маршрутизації передають сумнівні значення потрібному фахівцеві. Характеристики, що впливають на безпеку, відповідність вимогам чи повернення, варто перевіряти незалежно від оцінки.
Після публікації перевірте результат на вітрині: товари мають потрапляти в потрібні фільтри й добірки, а оновлення не повинні залишати застарілих тегів.
Автоматична класифікація можлива лише за умови узгодженої структури каталогу. Без неї той самий опис постачальника дасть різні значення в різних картках, і покупець побачить дублі у фільтрах та неповні добірки.
Таксономія впорядковує товари за категоріями й підкатегоріями, і кожна категорія має власний набір характеристик: для моніторів це діагональ і частота оновлення, для стільців це розміри й матеріал. Теги додають групування поверх цієї структури, наприклад регулювання висоти чи комплект 2 шт.
Перед обробкою даних постачальників варто визначити три речі:
Постачальники можуть описати підставку монітора як регулюється по висоті, регулювання висоти чи з налаштуванням висоти, і всі три варіанти зводяться до одного значення атрибута. Формулювання регульована підставка вимагає уточнення, бо регулювання може стосуватися нахилу, а не висоти.
Нормалізацію і тлумачення варто розділяти. Перетворення одиниць і зведення погоджених синонімів робить дані узгодженими, тоді як заміна декор під дуб на дуб у полі матеріалу змінює зміст запису.
PIM-система дає команді місце, де зберігаються структура категорій і визначення атрибутів, і класифікація, підключена до неї, застосовує ті самі правила до нових поставок, що й до наявного каталогу.
Нижче наведено два приклади того, що автоматична класифікація створює з типових даних постачальника. Оцінки впевненості умовні, а поріг перевірки в обох випадках становить 0,85: будь-яке значення нижче за нього потрапляє до фахівця перед публікацією.
Меблі: обідній стілець
Вхідні дані, рядок із прайсу постачальника в Excel:
Стілець Oslo дуб/тканина сіра 45х52х82, 2 шт/уп, розб.
Атрибут | Значення | Оцінка | Джерело | Статус |
|---|---|---|---|---|
Категорія | Меблі > Їдальня > Обідні стільці | 0,94 | Назва, фото | Підтверджено |
Матеріал каркаса | Дуб | 0,80 | Назва | На перевірку |
Матеріал оббивки | Тканина | 0,94 | Назва | Підтверджено |
Колір оббивки | Сірий | 0,95 | Назва, фото | Підтверджено |
Розміри (Ш × Г × В) | 45 × 52 × 82 см | 0,78 | Назва | На перевірку |
Кількість в упаковці | 2 | 0,97 | Назва | Підтверджено |
Збирання | Потрібне | 0,84 | Назва | На перевірку |
Стиль | Скандинавський | 0,72 | Фото | На перевірку |
Три значення не досягли порогу з конкретних причин. У назві не уточнено, чи дуб означає масив, шпон чи декор, розміри вказано без одиниць і порядку вимірювання, а потребу в збиранні система визначила за скороченням розб.
Запропонований тег: комплект 2 шт, якщо магазин групує товари за кількістю в упаковці.
Відкладені теги: масив дуба, дубовий каркас, потребує збирання і скандинавський стиль, доки відкриті значення не підтверджено.
Електроніка: монітор
Вхідні дані, короткий опис від постачальника:
Монітор 27" QHD IPS 165Гц 1мс, HDMI 2.0 x2, DP 1.4, регул. по висоті, VESA
Атрибут | Значення | Оцінка | Джерело | Статус |
|---|---|---|---|---|
Категорія | Електроніка > Монітори | 0,99 | Опис | Підтверджено |
Діагональ | 27" (68,6 см) | 0,99 | Опис | Підтверджено |
Роздільна здатність | 2560 × 1440 (QHD) | 0,95 | Опис | Підтверджено |
Тип матриці | IPS | 0,98 | Опис | Підтверджено |
Частота оновлення | 165 Гц | 0,99 | Опис | Підтверджено |
Час відгуку | 1 мс | 0,97 | Опис | Підтверджено |
Входи HDMI | 2 × HDMI 2.0 | 0,97 | Опис | Підтверджено |
DisplayPort | DisplayPort 1.4, кількість не вказано | 0,80 | Опис | На перевірку |
Регулювання підставки | По висоті | 0,94 | Опис | Підтверджено |
Кріплення VESA | Підтримується, стандарт не вказано | 0,70 | Опис | На перевірку |
Запропоновані теги: IPS, 165 Гц, регулювання висоти.
Відкладені значення: кількість портів DisplayPort і стандарт кріплення VESA, доки їх не підтвердить специфікація виробника.
Що показують приклади
Надійна класифікація відокремлює те, що постачальник указав прямо, від того, що ще потребує підтвердження. Вона зберігає джерело кожного значення, приводить значення до правил каталогу і створює теги лише з підтверджених атрибутів.
Незаповнене поле залишається видимим для команди як конкретне завдання на перевірку, і це значно безпечніше за припущення, яке відправить товар не в ту добірку.
Для продавця, який працює з кількома маркетплейсами, класифікація ускладнюється. Rozetka, Prom та Епіцентр мають власні дерева категорій і власні переліки обов'язкових характеристик, тому один товар доводиться зіставляти з кількома класифікаторами одночасно.
Картка товару без обов'язкових характеристик категорії може не пройти модерацію або потрапити на вітрину, але не з'являтися у фільтрах маркетплейсу. Різні назви й формати тих самих характеристик на різних майданчиках означають, що значення з вашого каталогу треба перетворювати під кожен канал окремо.
Автоматична класифікація допомагає, коли вона працює від власної таксономії каталогу, а відповідність категоріям кожного маркетплейсу задається правилами. Тоді значення перевіряють один раз у вашому каталозі, а для кожного каналу формуються вже з підтверджених даних.
Перевірка якості класифікації товарівСтабільний результат автоматична класифікація дає тоді, коли процес навколо неї налаштовано так само ретельно, як обрано інструмент. Мова про дві речі: заздалегідь вирішити, яким значенням можна довіряти без перевірки, і контролювати результат за вимірюваними показниками, а не вибірковими переглядами.
Практики, що підвищують точність
Перевірки до і після публікації
Перед публікацією автоматичні перевірки виявляють помилки, які не залежать від тлумачення:
Після публікації якість класифікації показують кілька метрик:
На демо більшість інструментів показує переконливий результат, бо працює на чистих тестових даних. Різниця стає видно на вашому каталозі, з вашими постачальниками і вашою таксономією.
Критерій | Що перевірити |
|---|---|
Оцінка впевненості | Чи має кожне значення оцінку і чи можна задавати поріг для окремого атрибута |
Джерело значення | Чи фіксує система, звідки взято значення: з назви, опису, специфікації чи фото |
Власна таксономія | Чи працює класифікація за вашим деревом категорій, чи нав'язує структуру вендора |
Нормалізація | Чи зводяться значення до ваших списків допустимих значень, одиниць і розмірних сіток |
Вхідні формати | Чи читає система фото, PDF-специфікації й Excel-файли постачальників |
Перевірка | Чи передаються сумнівні значення потрібному фахівцеві і чи можна змінювати правила без розробників |
Канали | Чи формує система дані під категорії кожного маркетплейсу з одного підтвердженого запису |
Ціноутворення | Як вартість залежить від розміру каталогу і чи оплачується повторна класифікація після зміни таксономії |
Пілот на власних даних
Найнадійніший спосіб порівняти вендорів полягає в пілоті на кількох сотнях реальних товарів з однієї-двох категорій. Дайте кожному той самий набір, включно зі складними позиціями від постачальників зі слабкими даними, і порівняйте результат з еталоном фахівця.
Частка прийнятих значень, кількість порожніх полів і кількість упевнених, але хибних значень скажуть більше за будь-який перелік функцій.
Окремий сервіс чи класифікація в PIM-системі
Окремий сервіс класифікації швидко запустити, але його результат доводиться експортувати й імпортувати в систему, де зберігаються дані про товари, і кожен такий цикл створює ризик розбіжностей. Класифікація всередині PIM-системи тримає значення, історію змін і підтвердження разом, хоча повне впровадження PIM на старті потрібне не кожній команді.
Вирішальне питання полягає в тому, чи можна почати лише з класифікації та розширитися пізніше без міграції даних.
Сервіс побудовано навколо описаних вище критеріїв. Кожне значення, яке визначає AI Enrichment, має оцінку впевненості й посилання на джерело, тож фахівець бачить, на чому ґрунтується кожне рішення.
Класифікація працює за деревом категорій, наборами атрибутів і списками значень клієнта завдяки гнучкій моделі даних. Пороги автоматичного підтвердження команда задає в Rule Engine без коду, а значення нижче порогу одразу потрапляють до потрібного фахівця.
Оплата кредитна: один кредит відповідає одному збагаченому SKU, і вартість залишається передбачуваною як для пілоту на одній категорії, так і для каталогу на сотні тисяч товарів. Почати можна лише зі збагачення, а згодом перейти на повну HootCore PIM без міграції даних.
Щоб побачити автоматичну класифікацію на власному каталозі, запишіться на демо, і наша команда покаже оцінки впевненості, правила перевірки та результати класифікації на товарах з ваших категорій.
Автоматична частина займає години, навіть для каталогу на десятки тисяч SKU. Загальний термін визначають підготовка й перевірка: узгодження таксономії та списків значень, пілот на одній категорії і перевірка значень нижче порогу.
Пілот із налаштуванням порогів зазвичай займає один-два тижні. Після цього класифікація працює для кожної нової поставки як звичайний крок, а черга на перевірку скорочується в міру того, як виправлення потрапляють у правила і словник.
Можна, якщо класифікація працює від власної таксономії каталогу, а відповідність категоріям кожного маркетплейсу задана правилами. Тоді значення підтверджують один раз, а для кожного каналу дані формуються з того самого підтвердженого запису.
Точність більше залежить від вхідних даних і типу характеристики, ніж від самої моделі. Значення, прямо вказані в специфікації постачальника, визначаються дуже надійно, тоді як значення, визначені за фото чи нечітким описом, несуть більший ризик.
Тому частка прийнятих значень для кожного атрибута на ваших власних товарах корисніша за загальний відсоток точності від вендора: вона показує, які поля можна публікувати автоматично, а які варто перевіряти.
Поспілкуйтеся з нашою командою та подивіться, як HootCore інтегрується у ваш існуючий tech stack — від управління товарними даними до обробки замовлень